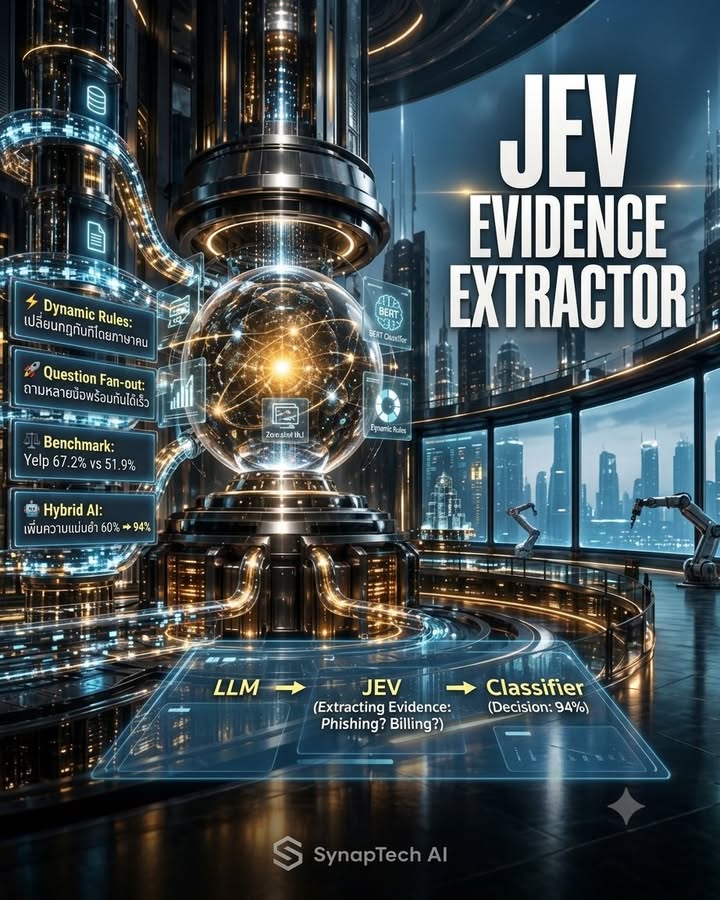
🚨 AI ตัวใหม่ที่คนกำลังพูดถึง อาจไม่ได้ “ใหม่” อย่างที่คิด!
🚨 AI ตัวใหม่ที่คนกำลังพูดถึง อาจไม่ได้ “ใหม่” อย่างที่คิด!
JEV กำลังถูกจับตามอง เพราะมันสามารถอ่านข้อมูลแล้ว “ตัดสินใจ” ได้ในระดับ มิลลิวินาที ⚡
แต่จุดที่น่าสนใจจริงๆ ไม่ใช่แค่ความเร็ว…
มันคือการทำให้ AI แบบ Classification สามารถ เปลี่ยนกฎตามคำสั่งภาษาคนได้ทันที โดยไม่ต้องเอาโมเดลไป Train ใหม่
🧠 JEV คืออะไร?
อธิบายง่ายๆ JEV ไม่ได้เกิดมาเพื่อเขียนบทความหรือคุยยาวๆ แบบ ChatGPT หรือ Claude
แต่มันถูกออกแบบมาเพื่อ “ตัดสินใจ” กับข้อมูลจำนวนมากแบบรวดเร็ว เช่น
• อีเมลนี้เป็น Spam หรือไม่? • ข้อความนี้ควรส่งไปแผนกไหน? • คำร้องนี้เร่งด่วนหรือเปล่า? • อีเมลนี้เข้าข่าย Phishing หรือไม่?
และสามารถคืนผลลัพธ์พร้อม ค่าความมั่นใจ เช่น “ใช่ 92%” หรือ “ไม่ใช่ 85%”
บางงานใช้เวลาเพียงระดับ 3–150ms
🔥 แต่ JEV ไม่ได้เป็นโมเดลประเภทใหม่
นี่คือจุดที่หลายคนอาจเข้าใจผิด
ระบบ Classification มีมานานแล้ว เช่น
• BERT (2018) สำหรับจำแนกข้อความ • โมเดล Encoder ขนาดเล็กที่สามารถทำงานบน CPU ได้ • Zero-shot NLI ที่สามารถจำแนกข้อมูลโดยไม่ต้องมี Dataset สำหรับงานนั้นโดยตรง
และในบาง Benchmark โมเดลแบบดั้งเดิมก็ยัง แม่นกว่า JEV ด้วยซ้ำ
แล้ว JEV มีอะไรที่น่าสนใจ?
⚡ 1. Dynamic Instruction Following
นี่คือความสามารถสำคัญ
คุณสามารถเปลี่ยน “กติกา” ให้มันได้ด้วยภาษาคน โดยไม่ต้อง Train โมเดลใหม่
เช่น
วันนี้ “คำขอยกเลิก → ส่งฝ่าย Billing”
พรุ่งนี้เปลี่ยนนโยบายเป็น “ถ้าเป็นองค์กรที่มีมากกว่า 100 Seats → ส่งให้ Manager”
ระบบสามารถเปลี่ยนวิธีตัดสินใจตาม Instruction ใหม่ได้ทันที
🚀 2. Question Fan-out
นี่เป็นอีกจุดที่น่าสนใจมาก
ถ้าถาม 1 คำถาม ใช้เวลาประมาณ 150ms
แต่ถ้าต้องการถามหลายคำถามพร้อมกัน เช่น 30 คำถาม เวลาประมวลผลไม่ได้เพิ่มขึ้นแบบเส้นตรงเหมือนระบบ Classification ทั่วไปบางประเภท
ทำให้เหมาะกับงานที่ต้องการ “สกัดหลักฐานหลายมุม” จากข้อมูลเดียว
📊 แล้ว JEV แม่นแค่ไหน?
ผลทดสอบที่ถูกพูดถึงให้ภาพค่อนข้างชัดว่า JEV ไม่ได้ชนะทุกงาน
ตัวอย่างเช่น
Banking77 โมเดลที่ Train มาแล้ว → 93.2% JEV Zero-shot → 80.1%
👉 งานนี้โมเดลดั้งเดิมชนะ
แต่ใน Yelp Reviews
JEV → 67.2% โมเดลดั้งเดิม → 51.9%
👉 JEV ชนะ โดยไม่ต้องมีข้อมูล Train สำหรับงานนั้น
ดังนั้นภาพจริงจึงไม่ใช่ “JEV มาแทนที่ Classification Model ทั้งหมด”
แต่คือ…
ถ้ามีข้อมูลสำหรับ Train → โมเดลดั้งเดิมยังมีข้อได้เปรียบ
ถ้าไม่มีข้อมูล Train และต้องการเปลี่ยนกฎบ่อย → JEV เริ่มน่าสนใจมากขึ้น
💡 และวิธีที่น่าสนใจที่สุด อาจไม่ใช่เลือก JEV หรือโมเดลเก่า
แต่คือ ใช้มันร่วมกัน
ตัวอย่างเช่น แทนที่จะถาม JEV ตรงๆ ว่า
«“อีเมลนี้เป็น Phishing หรือไม่?”»
อาจแตกออกเป็นตัวชี้วัดย่อยหลายข้อ แล้วให้ JEV ช่วย สกัดหลักฐาน
จากนั้นส่งผลลัพธ์ให้ Lightweight Classifier เป็นคนตัดสินใจขั้นสุดท้าย
ในตัวอย่างหนึ่ง ความแม่นยำเพิ่มจากประมาณ 60% → 94%
นี่ทำให้ JEV น่าสนใจในฐานะ “ตัวสกัดหลักฐานให้ระบบ AI” มากกว่าการเป็นผู้ตัดสินทุกอย่างด้วยตัวเอง
🎯 สรุปสั้นๆ
JEV ไม่ได้เกิดมาเพื่อฆ่า ChatGPT และไม่ได้มาแทน Classification Model ทั้งหมด
แต่มันกำลังชี้ให้เห็นแนวทางอีกแบบของ AI:
LLM เข้าใจคำสั่ง → JEV สกัดหลักฐาน → Classifier/Logic ตัดสินใจ
เร็วขึ้น ยืดหยุ่นขึ้น และไม่จำเป็นต้อง Train ใหม่ทุกครั้งที่กฎเปลี่ยน
คำถามคือ…
ถ้า AI สามารถเปลี่ยน “กฎการตัดสินใจ” ได้ทันทีโดยไม่ต้อง Train ใหม่ คุณคิดว่าจะมีงานอะไรบ้างที่เอา JEV ไปใช้ได้จริง? 👇
#JEV #AI #MachineLearning #AIEngineering #SynaptechAI
📖 อ่านบทความเต็มบน Facebook | 🔔 ติดตาม SynapTech
รับข่าว AI และบทความใหม่ก่อนผู้อื่น ส่งตรงถึง inbox
บทความแนะนำ
ถ้าชอบเนื้อหาแบบนี้
กดติดตาม SynapTech บน Facebook