🚨 Microsoft AI ส่งสัญญาณท้าชนยักษ์! โมเดล 2.8 ล้านล้านพารามิ…
🚨 Microsoft AI ส่งสัญญาณท้าชนยักษ์! โมเดล 2.8 ล้านล้านพารามิเตอร์ อ้างใช้พลังเทรนคุ้มกว่า DeepSeek สูงสุด 12.3 เท่า!
ถ้าคิดว่า Microsoft มีดีแค่ Windows, Copilot และการลงทุนใน OpenAI ข่าวนี้อาจทำให้ต้องมอง Microsoft AI ใหม่ครับ 🔥
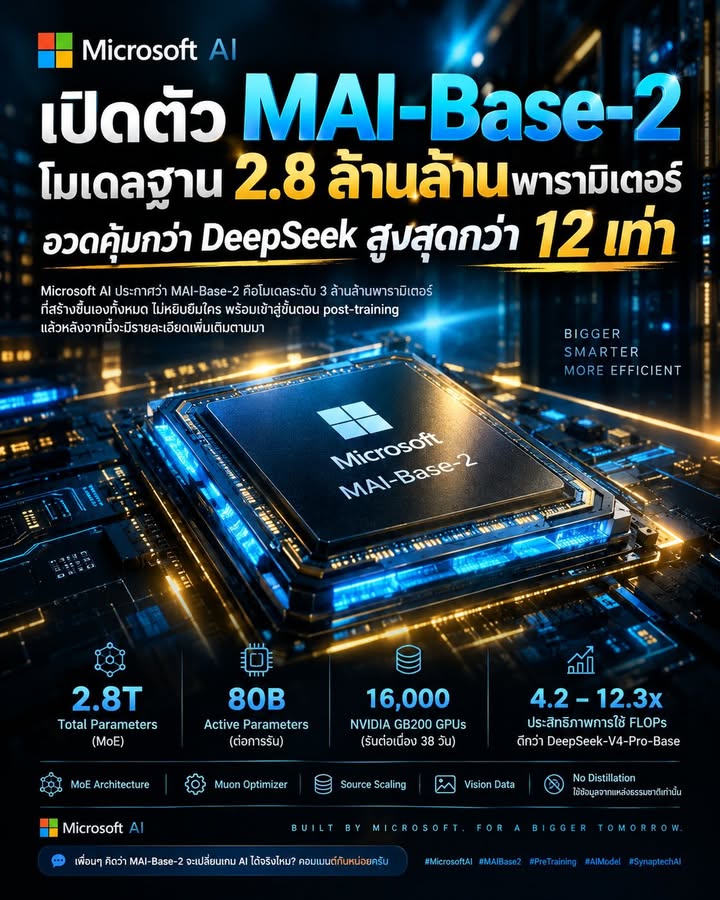
เพราะ Microsoft กำลังสร้างโมเดล AI ระดับแนวหน้าด้วยตัวเอง และครั้งนี้ไม่ได้มาเล่น ๆ แต่เปิดตัว MAI-Base-2 โมเดลฐานขนาดมหึมาที่มีพารามิเตอร์รวมถึง 2.8 ล้านล้านพารามิเตอร์ พร้อมตัวเลขประสิทธิภาพที่น่าจับตา
📌 MAI-Base-2 คืออะไร ทำไมวงการ AI ต้องสนใจ?
ตามข้อมูลที่เปิดเผยเมื่อวันที่ 15 ตุลาคม 2026 โดย Mustafa Suleyman ซีอีโอ Microsoft AI โมเดลนี้เป็น Foundation Model ที่ผ่านขั้นตอน Pre-training มาแล้ว และกำลังเข้าสู่กระบวนการ Post-training เพื่อพัฒนาไปสู่โมเดลที่พร้อมใช้งานจริง
แต่สิ่งที่น่าสนใจไม่ใช่แค่ขนาดของโมเดล เพราะเบื้องหลังยังมีรายละเอียดที่สะท้อนการแข่งขันของ AI ยุคใหม่อีกหลายด้าน
🧠 1. พารามิเตอร์ 2.8 ล้านล้าน แต่ไม่ได้ใช้ทั้งหมดทุกครั้ง
MAI-Base-2 ใช้สถาปัตยกรรม Mixture of Experts (MoE) ซึ่งแบ่งโมเดลออกเป็นผู้เชี่ยวชาญย่อยหลายส่วน และเลือกใช้เฉพาะส่วนที่จำเป็นต่อการประมวลผลแต่ละครั้ง
• พารามิเตอร์รวม: 2.8 ล้านล้าน • Active Parameters: ประมาณ 80,000 ล้าน
พูดง่าย ๆ คือ โมเดลมีความจุรวมขนาดใหญ่มาก แต่ไม่จำเป็นต้องเปิดใช้พารามิเตอร์ทั้งหมดในการประมวลผลทุกครั้ง
แนวทางนี้ช่วยให้โมเดลขนาดใหญ่สามารถบริหารต้นทุนการคำนวณได้มีประสิทธิภาพขึ้น อย่างไรก็ตาม จำนวนพารามิเตอร์เพียงอย่างเดียวไม่ได้การันตีว่าโมเดลจะฉลาดกว่าโมเดลขนาดเล็กเสมอไป
⚡ 2. เบื้องหลังการเทรน ใช้ GPU ระดับดาต้าเซ็นเตอร์ 16,000 ตัว
การฝึก MAI-Base-2 ใช้ NVIDIA GB200 จำนวน 16,000 ตัว ทำงานต่อเนื่องเป็นเวลา 38 วัน ในช่วงเดือนสิงหาคมถึงกันยายน 2026 ตามรายละเอียดที่ระบุในข้อมูลต้นทาง
นี่สะท้อนให้เห็นว่า การสร้าง Foundation Model ระดับแนวหน้าไม่ได้แข่งขันกันแค่เรื่องอัลกอริทึม แต่ยังต้องอาศัยโครงสร้างพื้นฐานด้านชิป ระบบจัดเก็บข้อมูล เครือข่าย และการจัดการกระบวนการฝึกขนาดใหญ่ด้วย
🏆 3. ตัวเลขที่ต้องจับตา: ประสิทธิภาพการใช้ FLOPs ดีกว่า DeepSeek สูงสุด 12.3 เท่า
Microsoft ระบุว่า MAI-Base-2 ทำผลงานเหนือกว่าโมเดล Open-weight ที่นำมาเปรียบเทียบบนชุดทดสอบที่กันข้อมูลไว้สำหรับประเมินผลโดยเฉพาะ
ที่สำคัญ บริษัทอ้างว่าโมเดลมีประสิทธิภาพการใช้ FLOPs ในขั้น Pre-training ดีกว่า DeepSeek-V4-Pro-Base อยู่ประมาณ 4.2–12.3 เท่า
แต่ต้องทำความเข้าใจให้ตรงกันก่อนครับ ตัวเลขนี้หมายถึงประสิทธิภาพด้านการคำนวณในการฝึกตามวิธีประเมินของบริษัท ไม่ได้หมายความว่า MAI-Base-2 ฉลาดกว่า เร็วกว่า หรือถูกกว่า DeepSeek ทุกงานถึง 12.3 เท่า
การเปรียบเทียบนี้ยังต้องพิจารณาวิธีวัด เงื่อนไขการทดลอง และผลทดสอบจากแหล่งอิสระประกอบด้วย
🔬 4. เบื้องหลังความคุ้มค่า ไม่ได้มีแค่การเพิ่มจำนวนชิป
เทคนิคสำคัญที่ข้อมูลต้นทางกล่าวถึง ได้แก่
• Scaling Laws: ใช้ศึกษาความสัมพันธ์ระหว่างขนาดโมเดล ปริมาณข้อมูล และทรัพยากรที่ใช้ฝึก • Source Scaling: จัดการสัดส่วนและการใช้ข้อมูลจากแหล่งต่าง ๆ รวมถึงควบคุมข้อมูลซ้ำ • MoE: เลือกใช้ผู้เชี่ยวชาญเฉพาะส่วน แทนการคำนวณผ่านโมเดลทั้งหมด • Muon Optimizer: เทคนิคปรับค่าระหว่างการฝึกเพื่อช่วยให้กระบวนการเรียนรู้มีประสิทธิภาพ • Activation Gradient Clipping: ควบคุมค่าระหว่างการฝึกเพื่อลดปัญหาความไม่เสถียร • Vision Data: ผสานข้อมูลภาพเข้าสู่กระบวนการฝึกตั้งแต่ต้น
เป้าหมายคือทำให้การฝึกโมเดลขนาดมหาศาลใช้ทรัพยากรได้คุ้มค่าที่สุด ไม่ใช่เพียงเพิ่มขนาดโมเดลให้ใหญ่ขึ้นเรื่อย ๆ
🛡️ 5. Microsoft ย้ำว่าไม่ได้กลั่นความรู้จากโมเดล AI ตัวอื่น
อีกประเด็นที่น่าสนใจคือ Microsoft ระบุว่าใช้ข้อมูลที่เรียกว่า Organic Data และไม่ได้ทำ Distillation จากโมเดลอื่น
Distillation คือกระบวนการนำผลลัพธ์หรือความรู้จากโมเดลต้นทางมาใช้ช่วยฝึกโมเดลอีกตัวหนึ่ง
การประกาศว่าไม่ได้ใช้วิธีดังกล่าวเป็นจุดยืนด้านกระบวนการพัฒนาโมเดลของ Microsoft แต่ไม่ได้หมายความว่าข้อมูลฝึกทั้งหมดปราศจากข้อถกเถียงเรื่องลิขสิทธิ์ หรือผ่านการตรวจสอบจากบุคคลภายนอกแล้วโดยอัตโนมัติ
สำหรับการเข้าถึงโมเดล บริษัทระบุแนวทางให้สิทธิ์ใช้งานน้ำหนักโมเดลผ่าน Foundry แก่พันธมิตรที่ได้รับเลือก ซึ่งหมายความว่าไม่ควรตีความว่าโมเดลนี้เปิดให้ทุกคนดาวน์โหลดไปใช้งานได้อย่างเสรี
🚀 6. ก้าวต่อไปที่สำคัญกว่า คือผลหลัง Post-training
ตอนนี้ MAI-Base-2 ยังเป็นโมเดลฐานที่ต้องผ่านการปรับแต่งเพิ่มเติม ก่อนจะประเมินได้ชัดเจนว่าจะนำไปใช้กับงานจริงได้ดีแค่ไหน
เพราะโมเดลฐานที่เก่งด้านการเรียนรู้รูปแบบข้อมูล ไม่ได้หมายความว่าจะพร้อมเป็นผู้ช่วยสนทนา เขียนโค้ด ใช้เครื่องมือ หรือทำงานซับซ้อนได้ดีทันที
สิ่งที่ต้องรอดูต่อจากนี้คือผล Benchmark ที่ตรวจสอบได้ ความสามารถในการใช้งานจริง ต้นทุนต่อคำตอบ ความเร็ว และข้อจำกัดในการนำไปให้บริการ
💬 สรุป: Microsoft กำลังเดิมพันกับประสิทธิภาพ ไม่ใช่แค่ขนาดโมเดล
MAI-Base-2 เป็นอีกสัญญาณว่าการแข่งขัน AI ระดับแนวหน้ากำลังขยับจากการแข่งกันว่าใครมีโมเดลใหญ่ที่สุด ไปสู่คำถามที่สำคัญกว่าเดิมว่า ใครฝึกโมเดลได้คุ้มกว่า และเปลี่ยนโมเดลนั้นให้กลายเป็นผลิตภัณฑ์ที่ใช้งานได้จริง
อย่างไรก็ตาม ตัวเลขทั้งหมดที่กล่าวถึงยังควรพิจารณาตามเงื่อนไขการทดสอบและข้อมูลจากแหล่งต้นทาง โดยเฉพาะคำกล่าวอ้างเรื่องประสิทธิภาพที่เหนือกว่า DeepSeek
คำถามคือ ถ้า Microsoft ทำโมเดลที่มีประสิทธิภาพสูงได้จริง คุณคิดว่าในอนาคต Microsoft AI จะกลายเป็นคู่แข่งตัวจริงของ OpenAI, Google และ DeepSeek ได้แค่ไหน? 👇
#MicrosoftAI #MAIBase2 #DeepSeek #AIFoundationModel #SynaptechAI
📖 อ่านบทความเต็มบน Facebook | 🔔 ติดตาม SynapTech
รับข่าว AI และบทความใหม่ก่อนผู้อื่น ส่งตรงถึง inbox
บทความแนะนำ
ถ้าชอบเนื้อหาแบบนี้
กดติดตาม SynapTech บน Facebook