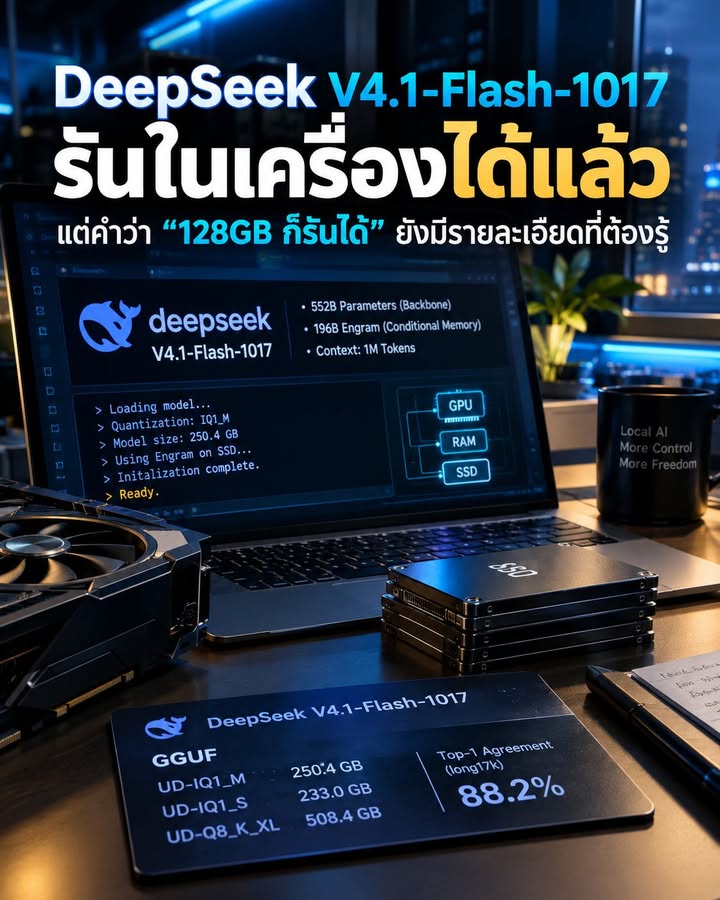
AI โมเดลขนาด 552B Parameters กำลังขยับเข้ามาในเครื่องส่วนตัว…
🔥 AI โมเดลขนาด 552B Parameters กำลังขยับเข้ามาในเครื่องส่วนตัว… แต่ RAM 128GB อาจยังไม่พออย่างที่คิด!
DeepSeek V4.1-Flash-1017 มีไฟล์ GGUF แบบบีบอัดที่ช่วยให้โมเดลขนาดมหึมาเข้าใกล้การรันบนเครื่องส่วนตัวมากขึ้น โดย Unsloth ใช้แนวทาง Quantization ร่วมกับการย้ายหน่วยความจำบางส่วนไปไว้บน SSD
แต่ประเด็นที่น่าสนใจกว่า คือ ไฟล์ขนาดกว่า 230–250GB สามารถทำงานร่วมกับ RAM ที่น้อยกว่าขนาดไฟล์ได้อย่างไร? และทำไมการมี RAM 128GB จึงไม่ได้การันตีว่าจะรันได้ทุกกรณี
🧠 1. บีบโมเดลเหลือ 250GB แต่ต้องแลกกับอะไร?
Unsloth เผยแพร่ไฟล์ GGUF หลายระดับสำหรับ DeepSeek V4.1-Flash-1017 เช่น
- UD-IQ1_M ขนาดประมาณ 250.4GB
- UD-IQ1_S ขนาดประมาณ 233GB
- UD-Q8_K_XL ขนาดประมาณ 508.4GB
ตัวเลขนี้แสดงให้เห็นว่า Quantization สามารถลดขนาดไฟล์โมเดลได้อย่างมาก แต่การบีบอัดที่หนักขึ้นก็อาจกระทบคุณภาพการทำงานได้เช่นกัน
ตัวอย่างเช่น UD-IQ1_M มีค่า Top-1 Agreement อยู่ที่ 88.2% บนชุดทดสอบ long17k
⚠️ อย่าเข้าใจผิดว่า AI ตอบถูก 88.2% เพราะตัวเลขนี้วัดความตรงกันของ token อันดับหนึ่งกับโมเดลอ้างอิง ไม่ใช่คะแนนความถูกต้องของคำตอบในทุกงาน
💾 2. RAM 128GB รันโมเดล 250GB ได้จริงไหม?
คำตอบคือ ต้องดูการจัดการหน่วยความจำและไฟล์รุ่นที่เลือก ไม่ใช่ดูขนาดไฟล์อย่างเดียว
แนวทางของ Unsloth ใช้ Engram ซึ่งเป็นส่วนหน่วยความจำแบบตาราง Lookup โดยสามารถวางส่วนนี้ไว้บน SSD และอ่านข้อมูลที่จำเป็นระหว่างทำงานได้
สำหรับ UD-IQ1_M ขนาด 250.4GB แบ่งเป็นส่วน Non-Engram ประมาณ 139.8GB และ Engram อีก 110.6GB
นั่นหมายความว่า เฉพาะส่วน Non-Engram ก็ใหญ่กว่า 128GB แล้ว จึงไม่ควรสรุปว่าเครื่อง RAM 128GB จะรันรุ่นนี้ได้แน่นอน
ส่วน UD-IQ1_S ขนาดประมาณ 233GB มี Non-Engram ราว 122.4GB ซึ่งใกล้เคียงกับ RAM 128GB มากกว่า แต่ยังต้องเผื่อหน่วยความจำให้ระบบปฏิบัติการ Runtime และ Context ด้วย
ตัวเลขที่ใช้พิจารณาจึงต้องรวม RAM กับ VRAM หรือ Unified Memory ตามรูปแบบเครื่อง และต้องดูวิธีจัดการ Engram บน SSD ประกอบด้วย
⚡ 3. เปิดโมเดลได้ ไม่ได้แปลว่าจะใช้งานได้เร็ว
ต่อให้เครื่องสามารถโหลดโมเดลขึ้นมาทำงานได้ ก็ยังมีอีกคำถามสำคัญคือ จะสร้างคำตอบได้เร็วแค่ไหน?
ประสิทธิภาพจริงขึ้นอยู่กับหลายปัจจัย ทั้ง GPU, Memory Bandwidth, CPU, ความเร็ว SSD และการแบ่งงานระหว่างอุปกรณ์
ยิ่งเป็น AI Agent ที่ต้องอ่านไฟล์ เขียนโค้ด เรียกใช้เครื่องมือ และตรวจสอบผลลัพธ์หลายรอบ ความเร็วในการตอบเพียงอย่างเดียวก็ไม่เพียงพอ
เราต้องดูด้วยว่าทำงานสำเร็จหรือไม่ ต้องแก้กี่รอบ และใช้เวลาจนจบงานจริงเท่าไร
🔬 4. ทำไมโมเดลนี้ถึงน่าจับตา?
DeepSeek V4.1-Flash-1017 มีโครงสร้าง Backbone 552B Parameters ร่วมกับ Engram Conditional Memory 196B และรองรับ Context สูงสุด 1M Tokens
รุ่นนี้ยังมุ่งปรับปรุงความสามารถด้าน Reasoning, Coding, AI Agent และ Vision
อย่างไรก็ตาม Context 1M Tokens เป็นขีดความสามารถที่โมเดลรองรับ ไม่ได้หมายความว่าเครื่องสเปกต่ำจะใช้งาน Context เต็มขนาดได้โดยไม่มีข้อจำกัด
และคะแนน Benchmark ของโมเดลต้นฉบับก็ไม่ควรถูกนำมาใช้แทนคะแนนของรุ่น Quantization โดยตรง
🛠️ 5. ก่อนดาวน์โหลด ต้องเช็ก Runtime ให้ดี
อีกจุดที่คนสนใจ Local AI ควรรู้คือ ไม่ใช่ทุก Runtime จะรองรับโมเดลและวิธีจัดการหน่วยความจำนี้ได้ทันที
ตามข้อมูลต้นทาง ณ วันที่ 21 ตุลาคม 2026 คู่มือ Unsloth ระบุแนวทางผ่าน Branch เฉพาะของ llama.cpp หรือ Unsloth Desktop ที่รองรับ
ดังนั้น อย่าเพิ่งคิดว่าโหลดไฟล์ GGUF มาแล้วจะเปิดใช้งานกับ llama.cpp, Ollama หรือ LM Studio รุ่นใดก็ได้ทันที ควรตรวจสอบสถานะการรองรับและขั้นตอนติดตั้งจากเอกสารต้นทางก่อน
🚀 บทสรุป: อนาคตของ Local AI อาจไม่ได้ขึ้นอยู่กับการเพิ่ม RAM หรือซื้อ GPU แพง ๆ เพียงอย่างเดียว
สิ่งที่กำลังเปลี่ยนคือวิธีบริหารหน่วยความจำ โดยให้ GPU จัดการงานคำนวณที่ต้องการความเร็ว ใช้ RAM รองรับข้อมูลที่จำเป็น และใช้ SSD เก็บข้อมูลบางส่วนที่ไม่ต้องอยู่ในหน่วยความจำตลอดเวลา
นี่เป็นทิศทางที่น่าสนใจสำหรับคนทำ AI Agent, Coding Agent และคนที่ต้องการรันโมเดลบนเครื่องตัวเองเพื่อควบคุมข้อมูลและปรับระบบได้อย่างอิสระ
แต่คำถามสำคัญไม่ใช่แค่ “เครื่องเรารันโมเดลนี้ได้ไหม?”
ต้องถามต่อด้วยว่า รันได้เร็วพอหรือไม่ คุณภาพหลังบีบอัดยังเหมาะกับงานหรือเปล่า และเมื่อเทียบกับโมเดลขนาดเล็กกว่าแล้ว คุ้มค่าจริงหรือไม่
💬 ถ้าคุณมีเครื่อง RAM 128GB คุณจะลองรันโมเดลระดับนี้บนเครื่องตัวเองไหม หรือมองว่าการใช้โมเดลผ่าน Cloud ยังสะดวกและคุ้มค่ากว่า?
หมายเหตุ: เนื้อหาอ้างอิงเอกสารต้นทาง ยังไม่ได้ทดสอบรันโมเดลด้วยตนเอง
#DeepSeek #LocalAI #Unsloth #AIAgent #SynaptechAI
📖 อ่านบทความเต็มบน Facebook | 🔔 ติดตาม SynapTech
รับข่าว AI และบทความใหม่ก่อนผู้อื่น ส่งตรงถึง inbox
บทความแนะนำ
ถ้าชอบเนื้อหาแบบนี้
กดติดตาม SynapTech บน Facebook